RWKV 架构介绍:兼具 RNN 与 Transformer 优势的模型已集成进 transformers
Introducing RWKV - An RNN with the advantages of a transformer
Hugging Face 博客介绍 RWKV,一种融合 RNN 与 Transformer 优势的架构,已被集成进 transformers 库。
原文把 RWKV 在推理速度与显存上的取舍讲清楚,适合想了解 RNN 与 Transformer 混合架构的人参考。
ChatGPT 和基于聊天机器人的应用在自然语言处理(NLP)领域引起了极大关注。社区不断寻求强大、可靠且开源的模型,以满足其应用和用例的需求。 这些强大模型的兴起源于基于 transformer 的模型的普及和广泛采用,这类模型最早由 Vaswani 等人在 2017 年提出。这些模型显著超越了此前基于循环神经网络(RNN)的 SoTA NLP 模型,而后者在那篇论文之后被认为已经过时。 在这篇博客文章中,我们将介绍一种新架构 RWKV 的集成,它结合了 RNN 和 transformer 的优势,并且最近已被集成到 HF Mirror 的 transformers 库中。
RWKV 项目概览
RWKV 项目由 Bo Peng 发起并领导,他积极贡献和维护该项目。社区在官方 Discord 频道中组织起来,不断改进项目在多个主题上的成果,例如性能(RWKV.cpp、量化等)、可扩展性(数据集处理与抓取)以及研究(聊天微调、多模态微调等)。用于训练 RWKV 模型的 GPU 由 Stability AI 捐赠。
你可以通过加入官方 Discord 频道来参与其中,并在这两篇博客文章中进一步了解 RWKV 背后的总体思想:https://johanwind.github.io/2023/03/23/rwkv_overview.html / https://johanwind.github.io/2023/03/23/rwkv_details.html
Transformer 架构与 RNN
RNN 架构是最早被广泛用于处理数据序列的神经网络架构之一,与接收固定大小输入的经典架构不同。它将当前的“token”(即数据流中的当前数据点)、先前的“状态”作为输入,并计算预测的下一个 token 和预测的下一个状态。然后,新状态被用于计算下一个 token 的预测,依此类推。 RNN 还可以用于不同的“模式”,因此使得 RNN 能够应用于不同场景,正如 Andrej Karpathy 的博客文章 所述,例如一对一(图像分类)、一对多(图像描述)、多对一(序列分类)、多对多(序列生成)等。
 |
|---|
| 使用 RNN 的可能配置概览。来源:Andrej Karpathy 的博客文章 |
由于 RNN 在每一步都使用相同的权重来计算预测,因此受梯度消失问题影响,它们难以记住长距离序列中的信息。人们已经努力通过引入 LSTM 或 GRU 等新架构来解决这一限制。然而,迄今为止,transformer 架构被证明是解决这一问题最有效的方法。
在 Transformer 架构中,输入 token 在自注意力模块中同时被处理。这些 token 首先通过查询、键和值权重线性投影到不同的空间。由此产生的矩阵直接用于计算注意力分数(通过 softmax,如下所示),然后乘以值隐藏状态以获得最终的隐藏状态。这种设计使该架构能够有效缓解长距离序列问题,并且与 RNN 模型相比,还能实现更快的推理和训练。
 |
|---|
| Transformer 模型中注意力分数的公式。来源:Jay Alammar 的博客文章 |
 |
|---|
| RWKV 模型中注意力分数的公式。来源:RWKV 博客文章 |
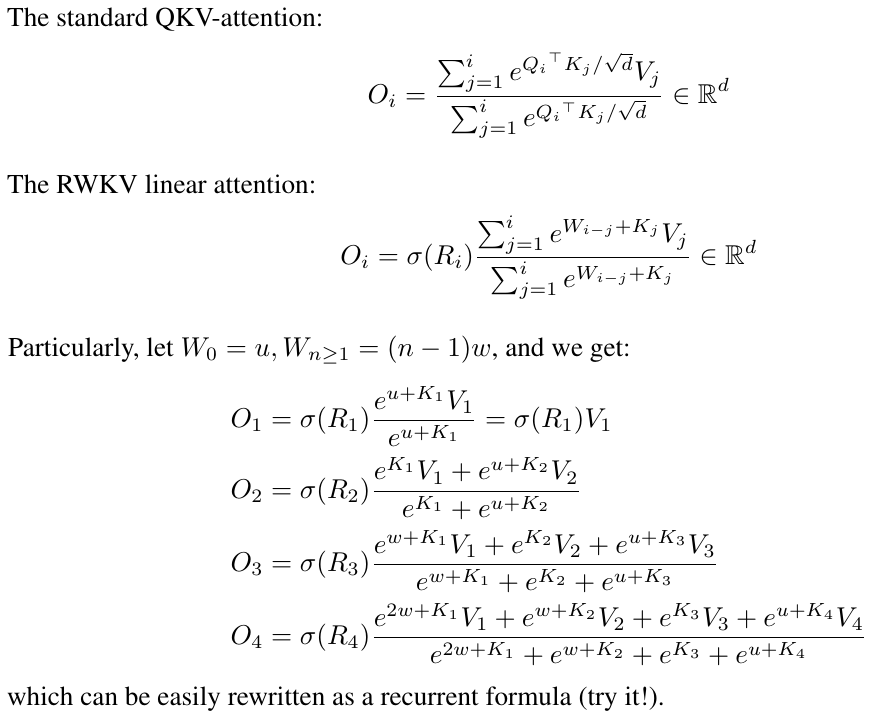
在训练过程中,Transformer 架构相比传统 RNN 和 CNN 具有多项优势。其中最显著的优势之一是它能够学习上下文表示。与一次处理一个单词的 RNN 和 CNN 不同,Transformer 架构将输入序列作为一个整体来处理。这使其能够捕捉序列中单词之间的长距离依赖关系,这对于语言翻译和问答等任务特别有用。
在推理过程中,RNN 在速度和内存效率方面具有一定优势。这些优势包括:由于只需要矩阵-向量运算而带来的简单性,以及由于推理期间内存需求不会增长而带来的内存效率。此外,由于计算仅作用于当前 token 和状态,计算速度不随上下文窗口长度变化而改变。
RWKV 架构
RWKV 受到 Apple 的 Attention Free Transformer 的启发。该架构经过了精心的简化和优化,使其能够转换为 RNN。此外,还添加了许多技巧,例如 TokenShift 和 SmallInitEmb(技巧列表列在官方 GitHub 仓库的 README中),以提升其性能以匹配 GPT。如果没有这些,模型的性能就不会如此出色。
在训练方面,目前已有一套基础设施可将训练规模扩展至 140 亿参数,并且一些数值不稳定性等问题已在 RWKV-4(截至今日的最新版本)中被迭代修复。
RWKV 作为 RNN 和 Transformer 的结合
如何将 Transformer 和 RNN 的最佳特性结合起来?基于 Transformer 的模型的主要缺点在于,当上下文窗口超过某个值时,运行模型会变得困难,因为注意力分数是针对整个序列同时计算的。
RNN 原生支持非常长的上下文长度——仅受训练时所见上下文长度的限制,但通过精心编码,可以扩展到数百万个 token。目前,已有在 8192 上下文长度上训练的 RWKV 模型(ctx8192),它们的速度与ctx1024模型一样快,并且需要相同的内存。
传统 RNN 模型的主要缺点以及 RWKV 的不同之处:
- 传统 RNN 模型无法利用非常长的上下文(LSTM 作为语言模型时只能管理约 100 个 token)。然而,RWKV 可以利用数千个甚至更多的 token,如下所示:
 |
|---|
| 不同上下文长度和模型大小下的语言模型损失。来源:RWKV 原始仓库 |

- 传统的 RNN 模型在训练时无法进行并行化。RWKV 类似于一个“线性化的 GPT”,并且它的训练速度比 GPT 快。
通过将两种优势融合到单一架构中,希望 RWKV 能够发展成超越各部分之和的存在。
RWKV 注意力公式
该模型架构与经典基于 Transformer 的模型非常相似(即嵌入层、多个相同的层、层归一化,以及用于预测下一个 token 的因果语言建模头)。唯一的区别在于注意力层,它与传统的基于 Transformer 的模型完全不同。
为了更全面地理解注意力层,我们建议深入研究 Johan Sokrates Wind 的博客文章 中提供的详细解释。
现有检查点
纯语言模型:RWKV-4 模型
大多数采用的 RWKV 模型参数范围从约 170M 到 14B。根据 RWKV 概述 博客文章,这些模型已在 Pile 数据集上训练,并在不同基准上与其他最先进模型进行了评估,它们表现相当不错,与这些模型的结果非常可比。
 |
|---|
| RWKV-4 与其他常见架构的比较。来源:Johan Wind 的博客文章 |
指令微调/聊天版本:RWKV-4 Raven
Bo 还训练了一个 RWKV 架构的“聊天”版本,即 RWKV-4 Raven 模型。它是一个 RWKV-4 pile(在 The Pile 数据集上预训练的 RWKV 模型)模型,在 ALPACA、CodeAlpaca、Guanaco、GPT4All、ShareGPT 等上进行了微调。该模型有多种版本可用,包括在不同语言(仅英语、英语+中文+日语、英语+日语等)和不同规模(1.5B 参数、7B 参数、14B 参数)上训练的模型。
所有 HF 转换模型均可在 HF Mirror Hub 的 RWKV 组织 中找到。
🤗 Transformers 集成
得益于 此拉取请求,该架构已添加到 transformers 库中。截至撰写本文时,您可以通过从源码安装 transformers,或使用库的 main 分支来使用它。该架构与库紧密集成,您可以像使用任何其他架构一样使用它。
让我们通过下面的一些示例来了解。
文本生成示例
要根据输入提示生成文本,您可以使用 pipeline 来生成文本:
from transformers import pipeline

model_id = "RWKV/rwkv-4-169m-pile"

prompt = "\nIn a shocking finding, scientist discovered a herd of dragons living in a remote, previously unexplored valley, in Tibet. Even more surprising to the researchers was the fact that the dragons spoke perfect Chinese."

pipe = pipeline("text-generation", model=model_id)
print(pipe(prompt, max_new_tokens=20))
>>> [{'generated_text': '\nIn a shocking finding, scientist discovered a herd of dragons living in a remote, previously unexplored valley, in Tibet. Even more surprising to the researchers was the fact that the dragons spoke perfect Chinese.\n\nThe researchers found that the dragons were able to communicate with each other, and that they were'}]
或者您可以从下面的代码片段运行并开始:
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("RWKV/rwkv-4-169m-pile")
tokenizer = AutoTokenizer.from_pretrained("RWKV/rwkv-4-169m-pile")

prompt = "\nIn a shocking finding, scientist discovered a herd of dragons living in a remote, previously unexplored valley, in Tibet. Even more surprising to the researchers was the fact that the dragons spoke perfect Chinese."

inputs = tokenizer(prompt, return_tensors="pt")
output = model.generate(inputs["input_ids"], max_new_tokens=20)
print(tokenizer.decode(output[0].tolist()))
>>> In a shocking finding, scientist discovered a herd of dragons living in a remote, previously unexplored valley, in Tibet. Even more surprising to the researchers was the fact that the dragons spoke perfect Chinese.\n\nThe researchers found that the dragons were able to communicate with each other, and that they were
使用 raven 模型(聊天模型)
您可以用 alpaca 风格提示聊天模型,下面是一个示例:
from transformers import AutoTokenizer, AutoModelForCausalLM

model_id = "RWKV/rwkv-raven-1b5"

model = AutoModelForCausalLM.from_pretrained(model_id).to(0)
tokenizer = AutoTokenizer.from_pretrained(model_id)

question = "Tell me about ravens"
prompt = f"### Instruction: {question}\n### Response:"

inputs = tokenizer(prompt, return_tensors="pt").to(0)
output = model.generate(inputs["input_ids"], max_new_tokens=100)

print(tokenizer.decode(output[0].tolist(), skip_special_tokens=True))
>>> ### Instruction: Tell me about ravens
### Response: RAVENS are a type of bird that is native to the Middle East and North Africa. They are known for their intelligence, adaptability, and their ability to live in a variety of environments. RAVENS are known for their intelligence, adaptability, and their ability to live in a variety of environments. They are known for their intelligence, adaptability, and their ability to live in a variety of environments.
根据 Bo 的说法,更好的指令技术在 此 Discord 消息中有详细说明(请确保在点击前加入频道)
|  |
权重转换
任何用户都可以通过简单地运行 transformers 库中提供的转换脚本,轻松地将原始 RWKV 权重转换为 HF 格式。首先,将“原始”权重推送到 HF Mirror Hub(我们将该仓库记为 RAW_HUB_REPO,原始文件记为 RAW_FILE),然后运行转换脚本:
python convert_rwkv_checkpoint_to_hf.py --repo_id RAW_HUB_REPO --checkpoint_file RAW_FILE --output_dir OUTPUT_DIR
如果您想将转换后的模型推送到 Hub(假设在 dummy_user/converted-rwkv 下),首先别忘了在推送模型前用 huggingface-cli login 登录,然后运行:
python convert_rwkv_checkpoint_to_hf.py --repo_id RAW_HUB_REPO --checkpoint_file RAW_FILE --output_dir OUTPUT_DIR --push_to_hub --model_name dummy_user/converted-rwkv
未来工作
多语言 RWKV
Bo 目前正在构建一个多语言语料库来训练 RWKV 模型。最近发布了一个新的多语言分词器 。
面向社区的研究项目
RWKV 社区非常活跃,正在围绕多个后续方向开展工作,你可以在 Discord 上的专属频道中找到一系列有趣的项目(点击链接前请确保已加入该频道)。 还有一个专门讨论该架构研究的频道,欢迎加入并贡献!
模型压缩与加速
由于只需要进行矩阵-向量运算,RWKV 是光子处理器/加速器等非标准与实验性计算硬件的理想候选。
因此,该架构也能自然地受益于经典的加速与压缩技术(例如 ONNX、4 位/8 位量化等),我们希望随着该架构与 transformers 的集成,这些技术能惠及广大开发者和从业者。
RWKV 还能在不久的将来受益于 optimum 库所提出的加速技术。
其中一些技术在 rwkv.cpp 仓库或 rwkv-cpp-cuda 仓库中有重点介绍。
致谢
HF Mirror 团队想感谢 Bo 和 RWKV 社区付出的时间,以及解答我们关于该架构的问题。我们还要感谢他们的帮助与支持,并期待看到 RWKV 模型在 HF 生态系统中得到更广泛的应用。
我们还要感谢 Johan Wind 关于 RWKV 的博文,它帮助我们深入理解了该架构及其潜力。
最后,我们要特别感谢并认可 ArEnSc 发起的初始 transformers PR。
还要大力感谢 Merve Noyan、Maria Khalusova 和 Pedro Cuenca 对这篇博文的悉心审阅,使其更加完善!
引用
如果你在工作中使用了 RWKV,请使用以下 cff 引用。
来源:Hugging Face Blog · hf-mirror.com