H 公司发布 Holo4 系列计算机操作智能体模型
Holo4: powering generalist computer-use agents
H 公司发布 Holo4 系列智能体模型,包含 27B dense 和 35B-A3B MoE 两个版本,并同步更新 Holotron4 Nano,权重已在 Hugging Face 提供 BF16、FP8、NVFP4 和 4-bit GGUF 格式。
可以了解一个通用计算机操作智能体如何在单一模型内统一 GUI、代码与 MCP 接口,以及它与闭源前沿模型的成本差距。
Holo4 是我们全新的智能体模型系列。它有两个尺寸:27B dense 和 35B-A3B Mixture of Experts。两者均可在 H Models API 上使用。我们还发布了 Holotron 3 的更新版本:Holotron4 Nano。
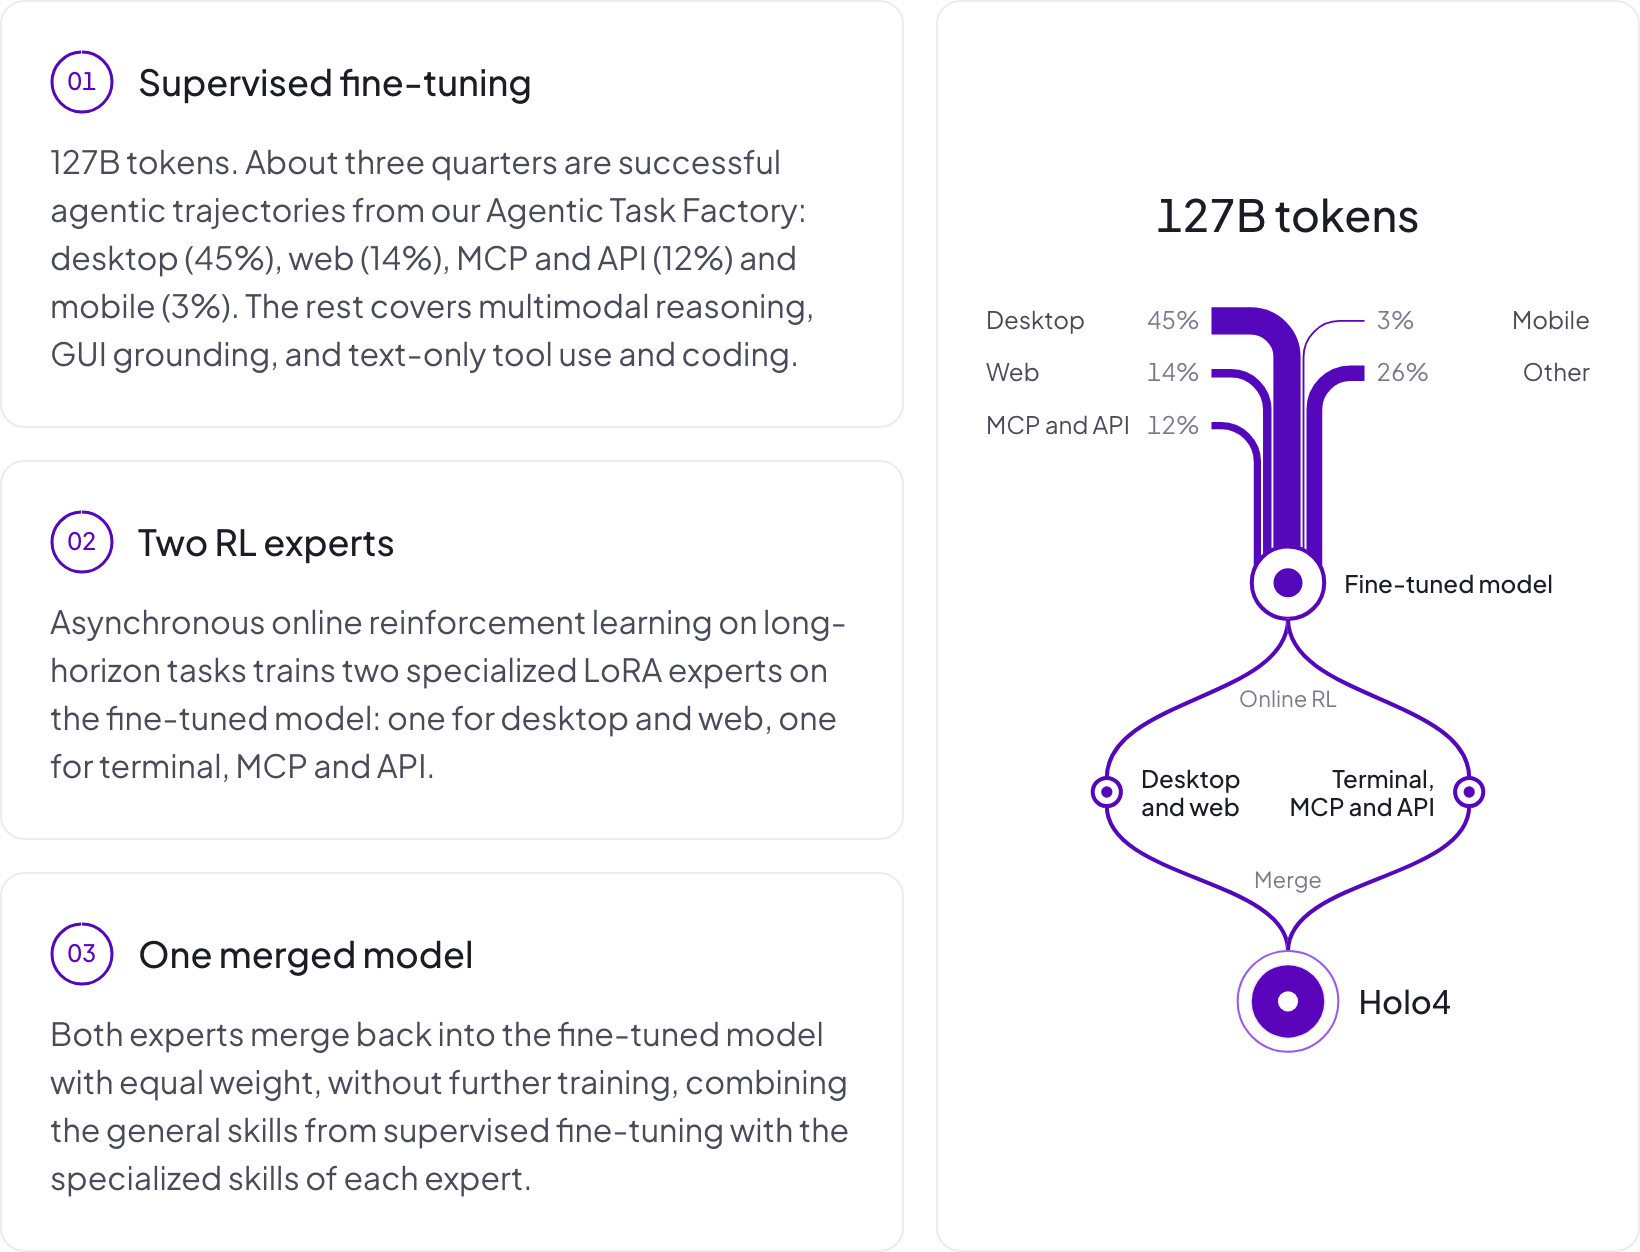
Holo4 基于我们此前的模型构建,可通过任何可用接口与软件交互:GUI、代码、MCP 和 API。它在学术基准测试中表现良好,但我们是专为真实业务工作流打造的。它通过监督学习和强化学习,在大量环境和任务上训练,其中包括由我们的 Agentic Task Factory 生成的环境和任务。
立即开始:
- 🤖 模型: Holo4-27B | Holo4-35B-A3B | Holotron4 Nano
- 🗂️ 完整合集(FP16、FP8、GGUF): Holo4
- 🎞️ 轨迹: 查看器 | 数据集
- ⚡ H Models API: 快速上手
- 📝 完整博客文章: hcompany.ai/newsroom/holo4
为各种接口打造的模型
Holo4 可以在屏幕上点击和输入,编写并运行自己的代码,并调用 MCP 或 API 工具。它会选择最适合任务的方式。大多数智能体模型只针对单一接口训练:专注于 GUI 的模型离开屏幕就束手无策,而偏好工具调用的模型则会被困在没有 API 的应用程序前。真实工作并非如此割裂,一项业务任务可能需要组合这些不同的方法。
Holo4 可在桌面、网页、Android、代码沙盒以及业务 API 上运行。每种情况下都是同一个模型,调用方式也相同。你无需为每个平台选择不同的模型。
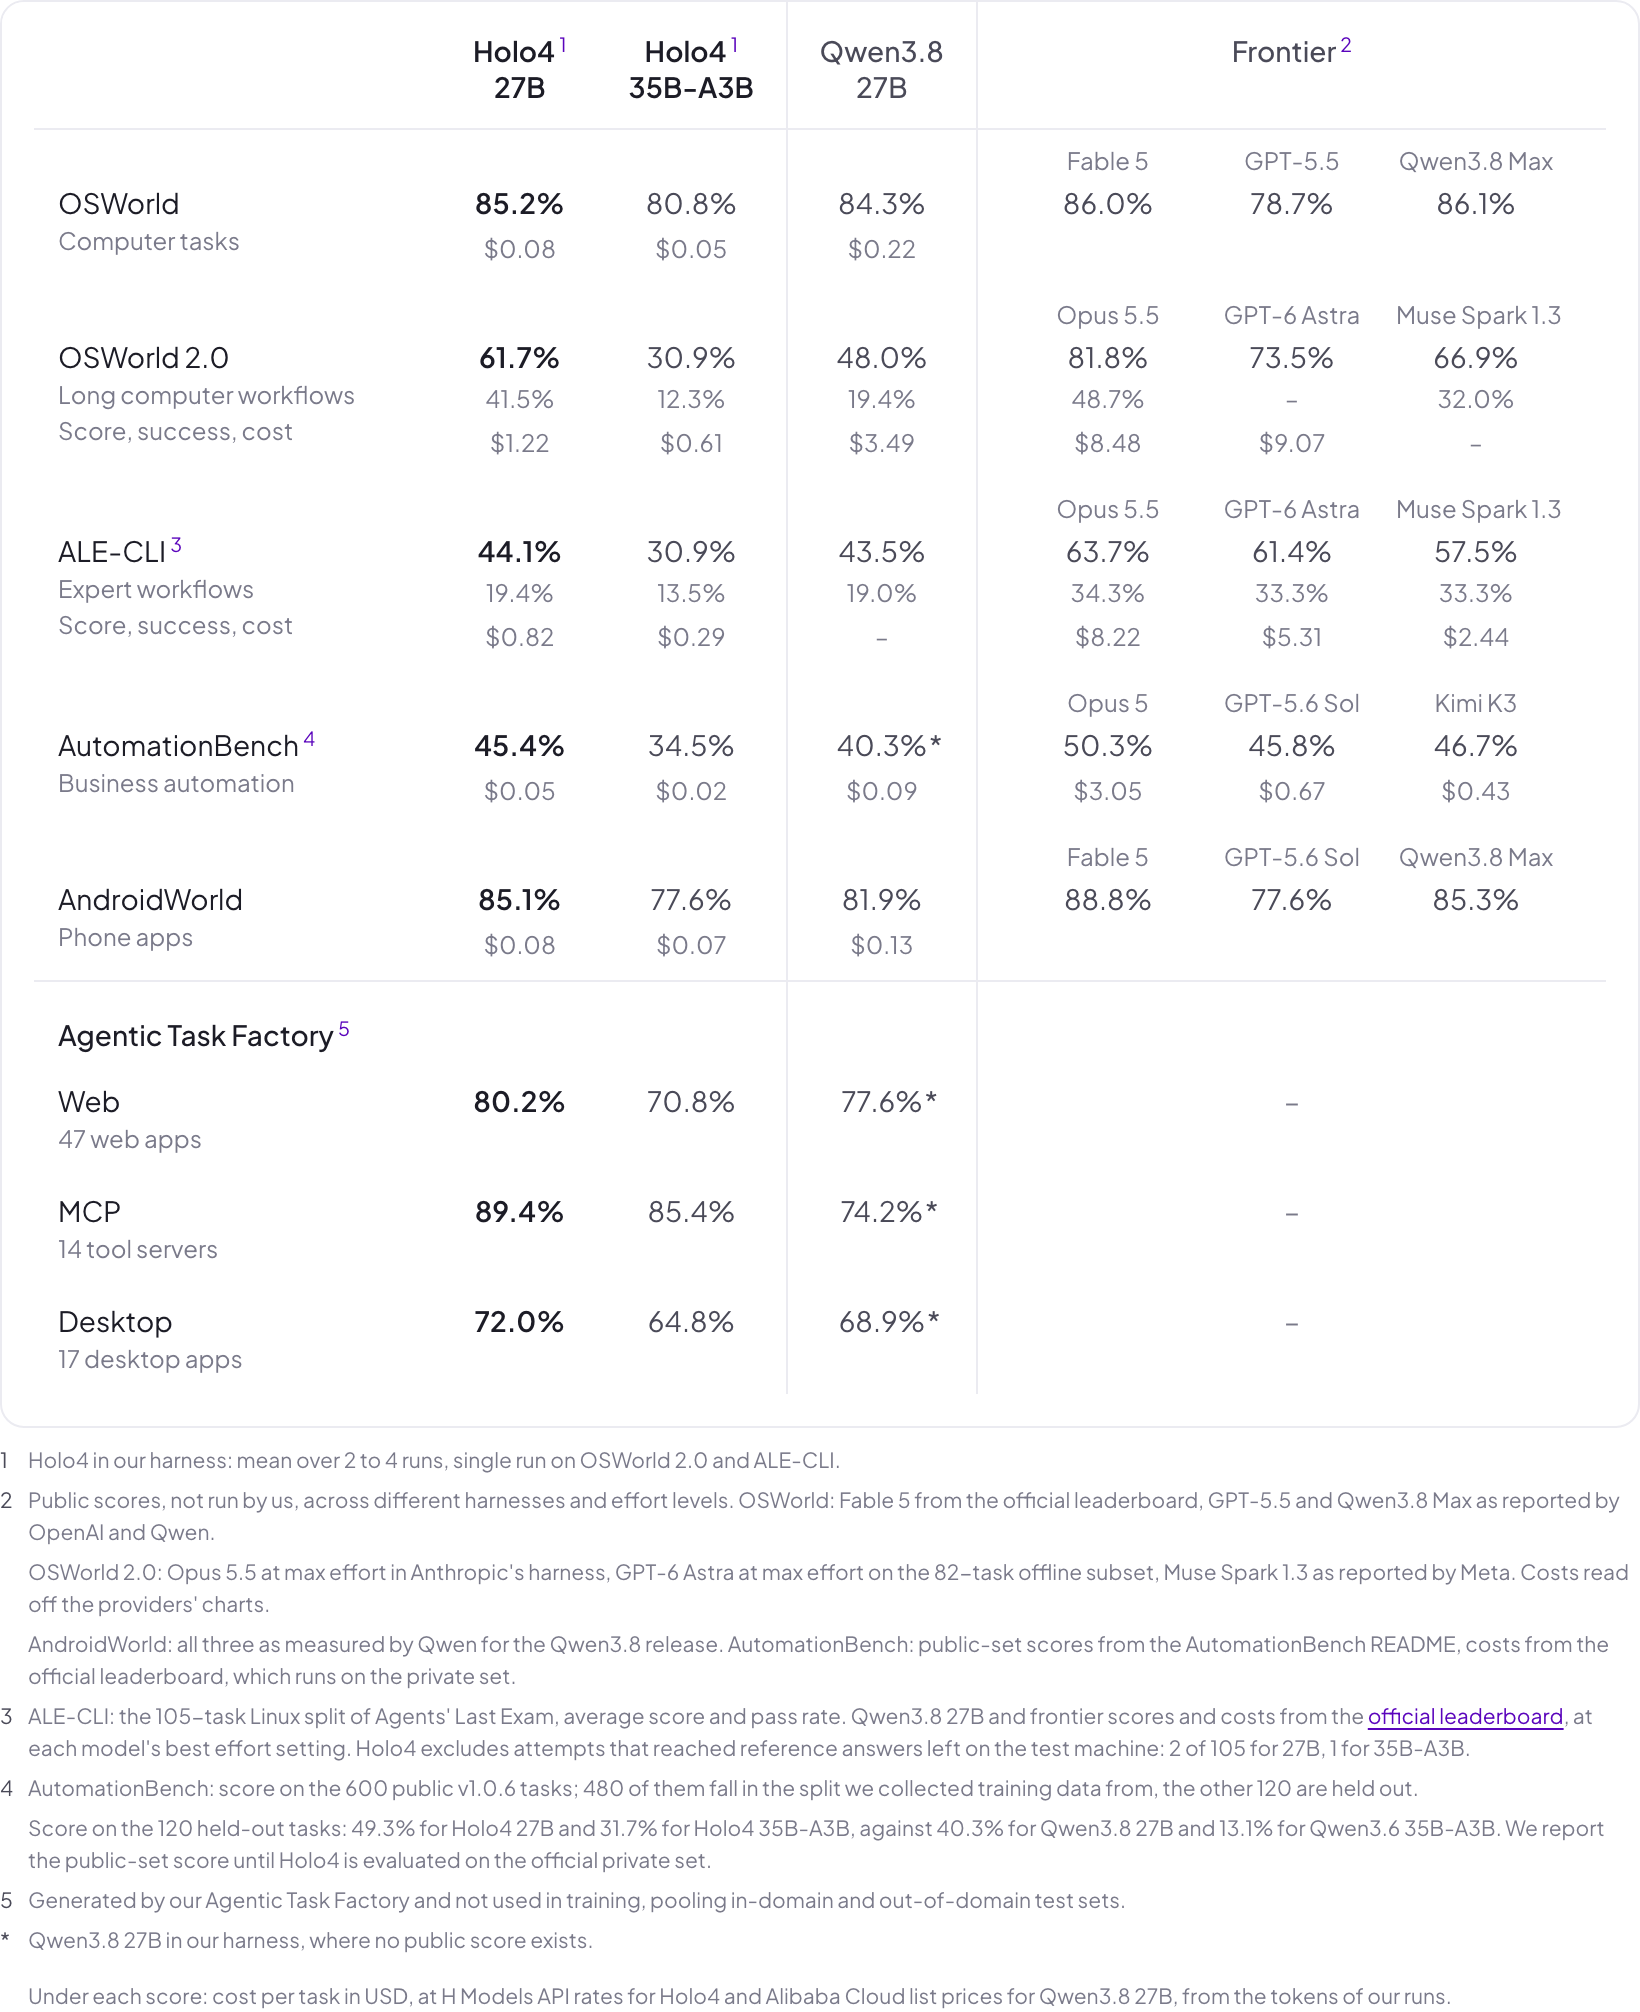
Holo4 模型相较其 Qwen 基座有显著提升。在长工作流上,Holo4 仅落后于最强的闭源模型:在 OSWorld 2.0 上,Holo4 27B 得分为 61.7%,而 Opus 5.5 为 81.8%;Holo4 35B-A3B 则达到 30.9%。然而,它是在参数量少几个数量级、成本低得多的情况下做到这一点的。我们开源了公开基准测试中所有得分背后的轨迹:可在 trajectories.hcompany.ai 回放每一步,或从 Hugging Face 下载。
以极低成本与前沿模型竞争
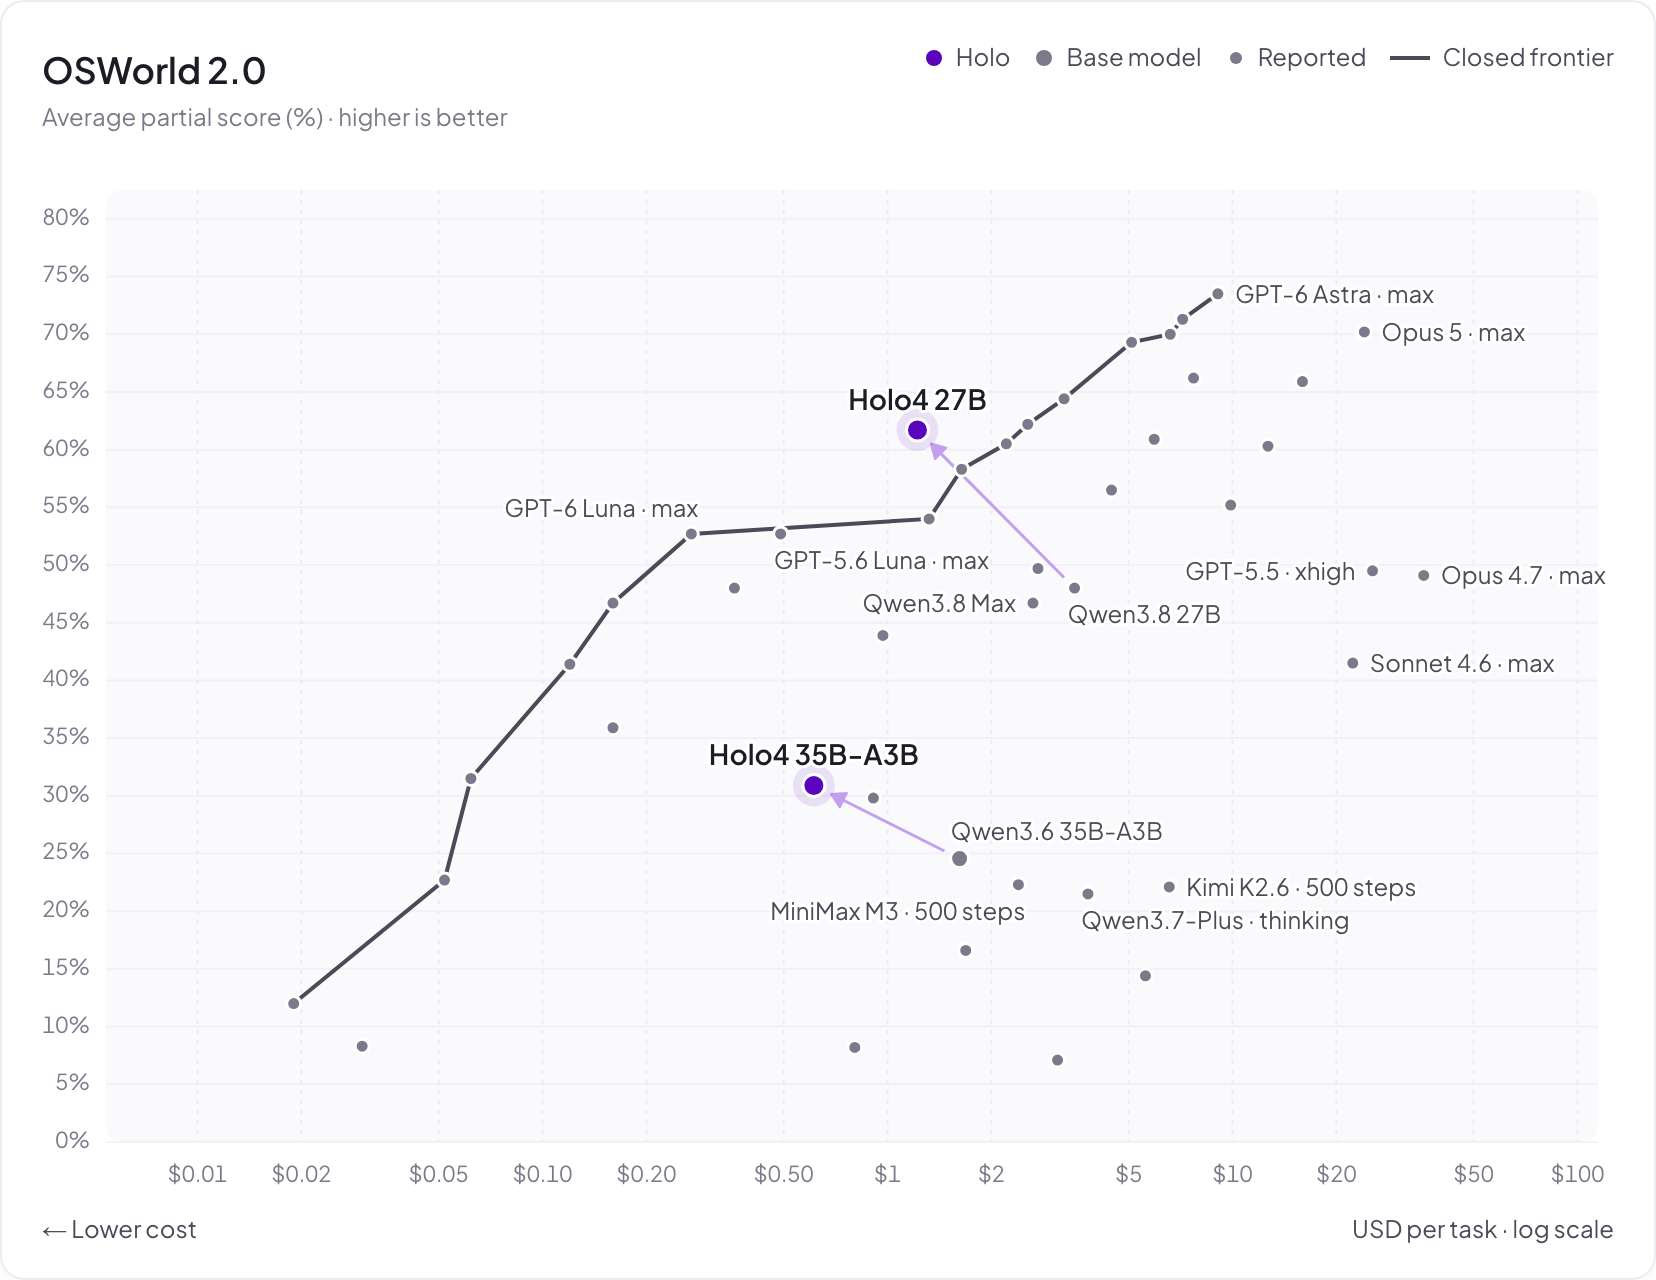
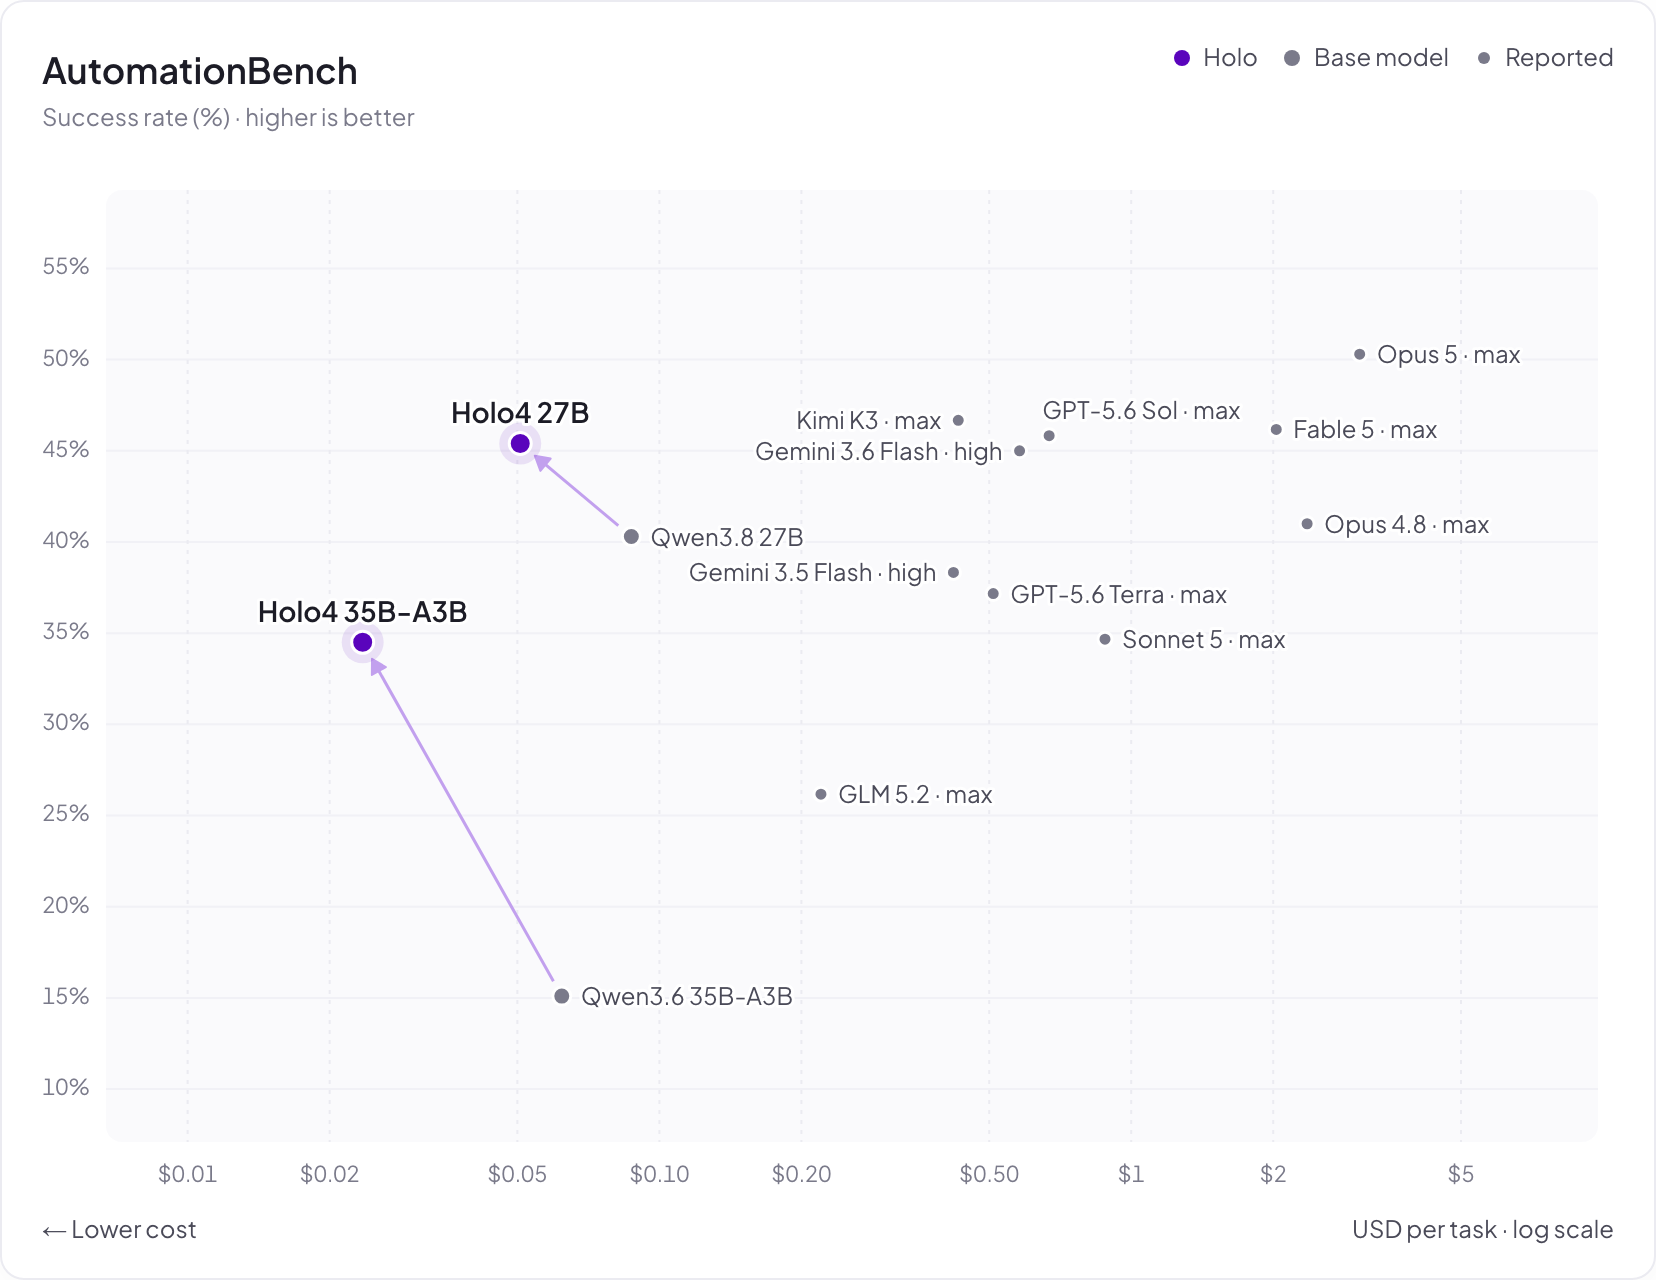
在桌面控制(OSWorld 2.0)和 API 使用(AutomationBench)最难的学术基准测试中,Holo4 以远低于前沿模型的每任务成本与之竞争。
关于成本-性能图表的说明
OSWorld 2.0。 成本根据每次智能体运行的输入和输出 token 估算。Holo4 按 H Models API 费率计价(单次运行)。Qwen3.8 27B:模型卡得分,成本来自我们在阿里云按目录价运行时的 token。Qwen3.6 35B-A3B:在我们测试框架中的单次运行,按阿里云目录价计算,缓存命中价格为输入价格的 20%。OpenAI 发布数据提供了 GPT 和 Opus 的 effort sweeps;其他闭源和开放权重数据点使用 官方 OSWorld 2.0 排行榜。发布版本、测试框架和任务子集各不相同。该连线连接闭源模型中非支配的得分与成本组合;Holo4 未包含在内。
AutomationBench。 Holo4、Qwen3.8 27B 和 Qwen3.6 35B-A3B:AutomationBench v1.0.6,分数和成本在我们的内部测试框架中测量。其他模型:公开集分数来自 AutomationBench README,每任务成本来自官方排行榜,该排行榜基于私有集运行。我们将在 Holo4 在私有集上评估后报告其结果。
能干活的人工智能
Holo4 模型基于我们 Agentic 任务工厂中的环境和任务训练,在专业软件上表现出色。以下示例展示了 Holo4 27B 与其基础模型 Qwen3.8 27B 的对比。两个模型使用相同的提示词和测试框架。
3D 建模 · 埃菲尔铁塔
在 FreeCAD 中构建埃菲尔铁塔的 3D 模型,比例为 1 毫米比 1 米,以原点为中心并与 X 轴和 Y 轴对齐。按照此设计进行制作。
铁塔在每个高度上的平面均为正方形,绝不为圆形。其半宽,即从中心轴向外到角点的距离,在地面处为 62.5 毫米,在高度 57 处为 32.5 毫米,在高度 115 处为 17.5 毫米,在高度 276 处为 9.35 毫米。在这些高度之间,半宽遵循一条平滑曲线,在靠近地面处急剧下降,在较高处平缓下降,绝不走直线。
四条相同的塔腿,每个象限一条,每条都是一个方形柱,其外角遵循该轮廓。每条塔腿在地面处宽 14 毫米,并在高度 276 处逐渐收窄至 4 毫米。塔腿从地面到第一个平台之间彼此分离,并在上升过程中逐渐收拢。它们之间没有任何填充物:铁塔是镂空的,从各个方向都能直接看穿。
三个平台,每个都是以中心轴为中心的实心方形板:高度 57 处宽 72 毫米、厚 4 毫米;高度 115 处宽 40 毫米、厚 3 毫米;高度 276 处宽 22 毫米、厚 3 毫米。
一根从高度 276 到 324 的桅杆,方形,底部宽 8 毫米,向顶端逐渐收窄至 2 毫米。
每个部件都必须是封闭的实体且体积非零,任何部件都不得填充塔腿之间的空间。
Holo4 27B(84 次调用,130 万 token)
Qwen3.8 27B(60 次调用,100 万 token)
3D 建模 · H 标志
在 FreeCAD 中构建 H 公司标志的 3D 模型:一个实心填充圆盘旁边是一个粗块状无衬线大写字母 H,两者拉伸至相同厚度,两个形状高度相近并彼此分开以避免重叠,圆盘的中心与 H 的中间齐平。将两个形状都涂成黑色。
Holo4 27B(94 次调用,150 万 token)
Qwen3.8 27B(118 次调用,190 万 token)
游戏设计 · 吃豆人
在 Godot 中构建一个吃豆人风格的游戏,并让它保持运行。
在网格上布置矩形迷宫墙壁,每个开放通道中都填满豆子。玩家标记沿通道持续移动,吃掉经过的每颗豆子并为其得一分。三个幽灵穿过相同的通道并追逐玩家。如果幽灵抓住玩家,玩家失去一条命,一切重置到起始位置。分数和生命值绘制在屏幕上。
没有人会来玩这个。玩家用简单的启发式规则自行驱动:在每个路口它朝最近的豆子前进,除非有幽灵靠近,此时它会远离幽灵移动。游戏必须无人值守地无限运行,完全不需要键盘输入。
当它运行成功时,启动游戏并让它持续运行。
Holo4 27B(68 次调用,240 万 token,268 行)
Qwen3.8 27B(197 次调用,1140 万 token,327 行)
我们如何构建 Holo4
智能体任务工厂
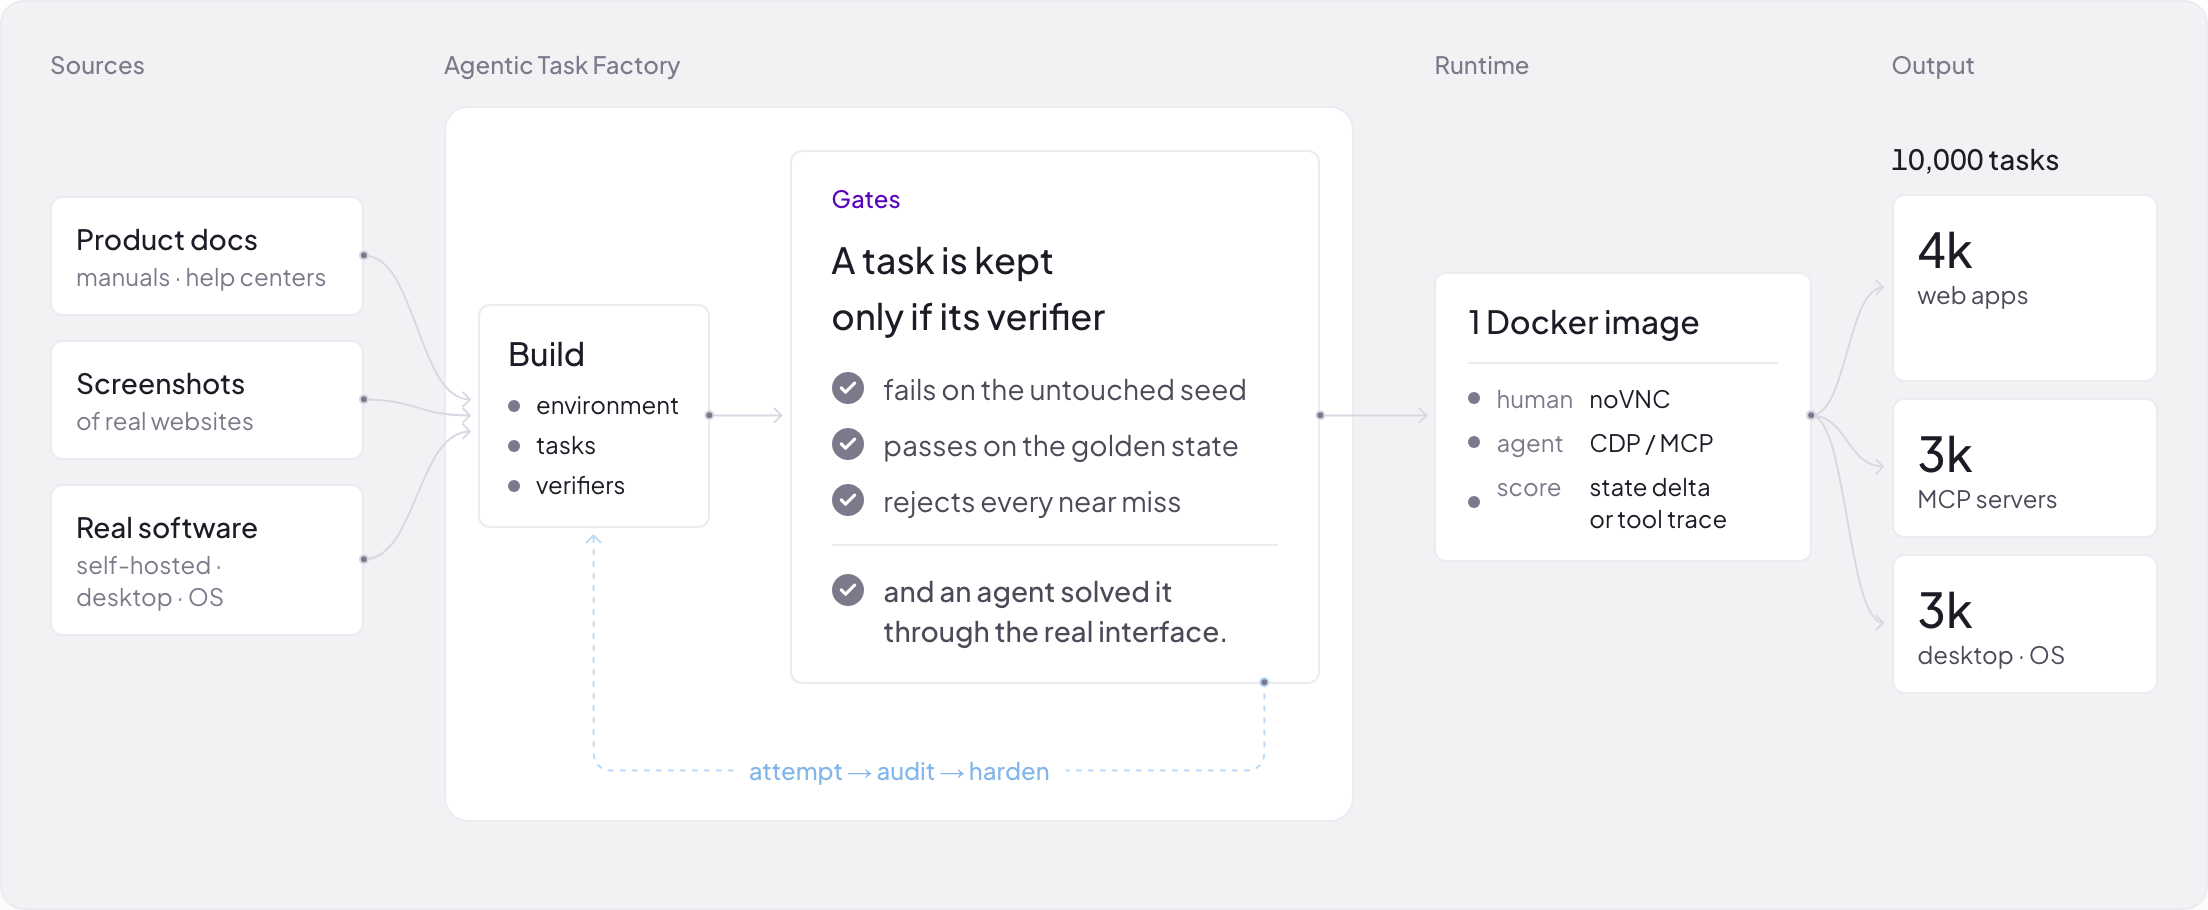
我们内部的智能体流水线套件仅凭文档即可构建交互式环境和可验证任务,例如真实网站或开源软件的截图。迄今为止,它已在 Web 应用、MCP 服务器和桌面环境中产出约 10,000 个任务,其中包括通过 GUI 和 MCP 暴露同一状态的混合环境。
训练
测试框架
在训练之外,我们还重建了测试框架——即执行模型动作并在数百步中管理其上下文的循环,并利用了 OSWorld 2.0 上智能体性能的反馈。智能体会标记每个任务失败的原因,工程师则审查相应的修复。其中最大的改动是为智能体提供可跟踪数百步的可靠记忆,以及在桌面机器本身上的 shell。
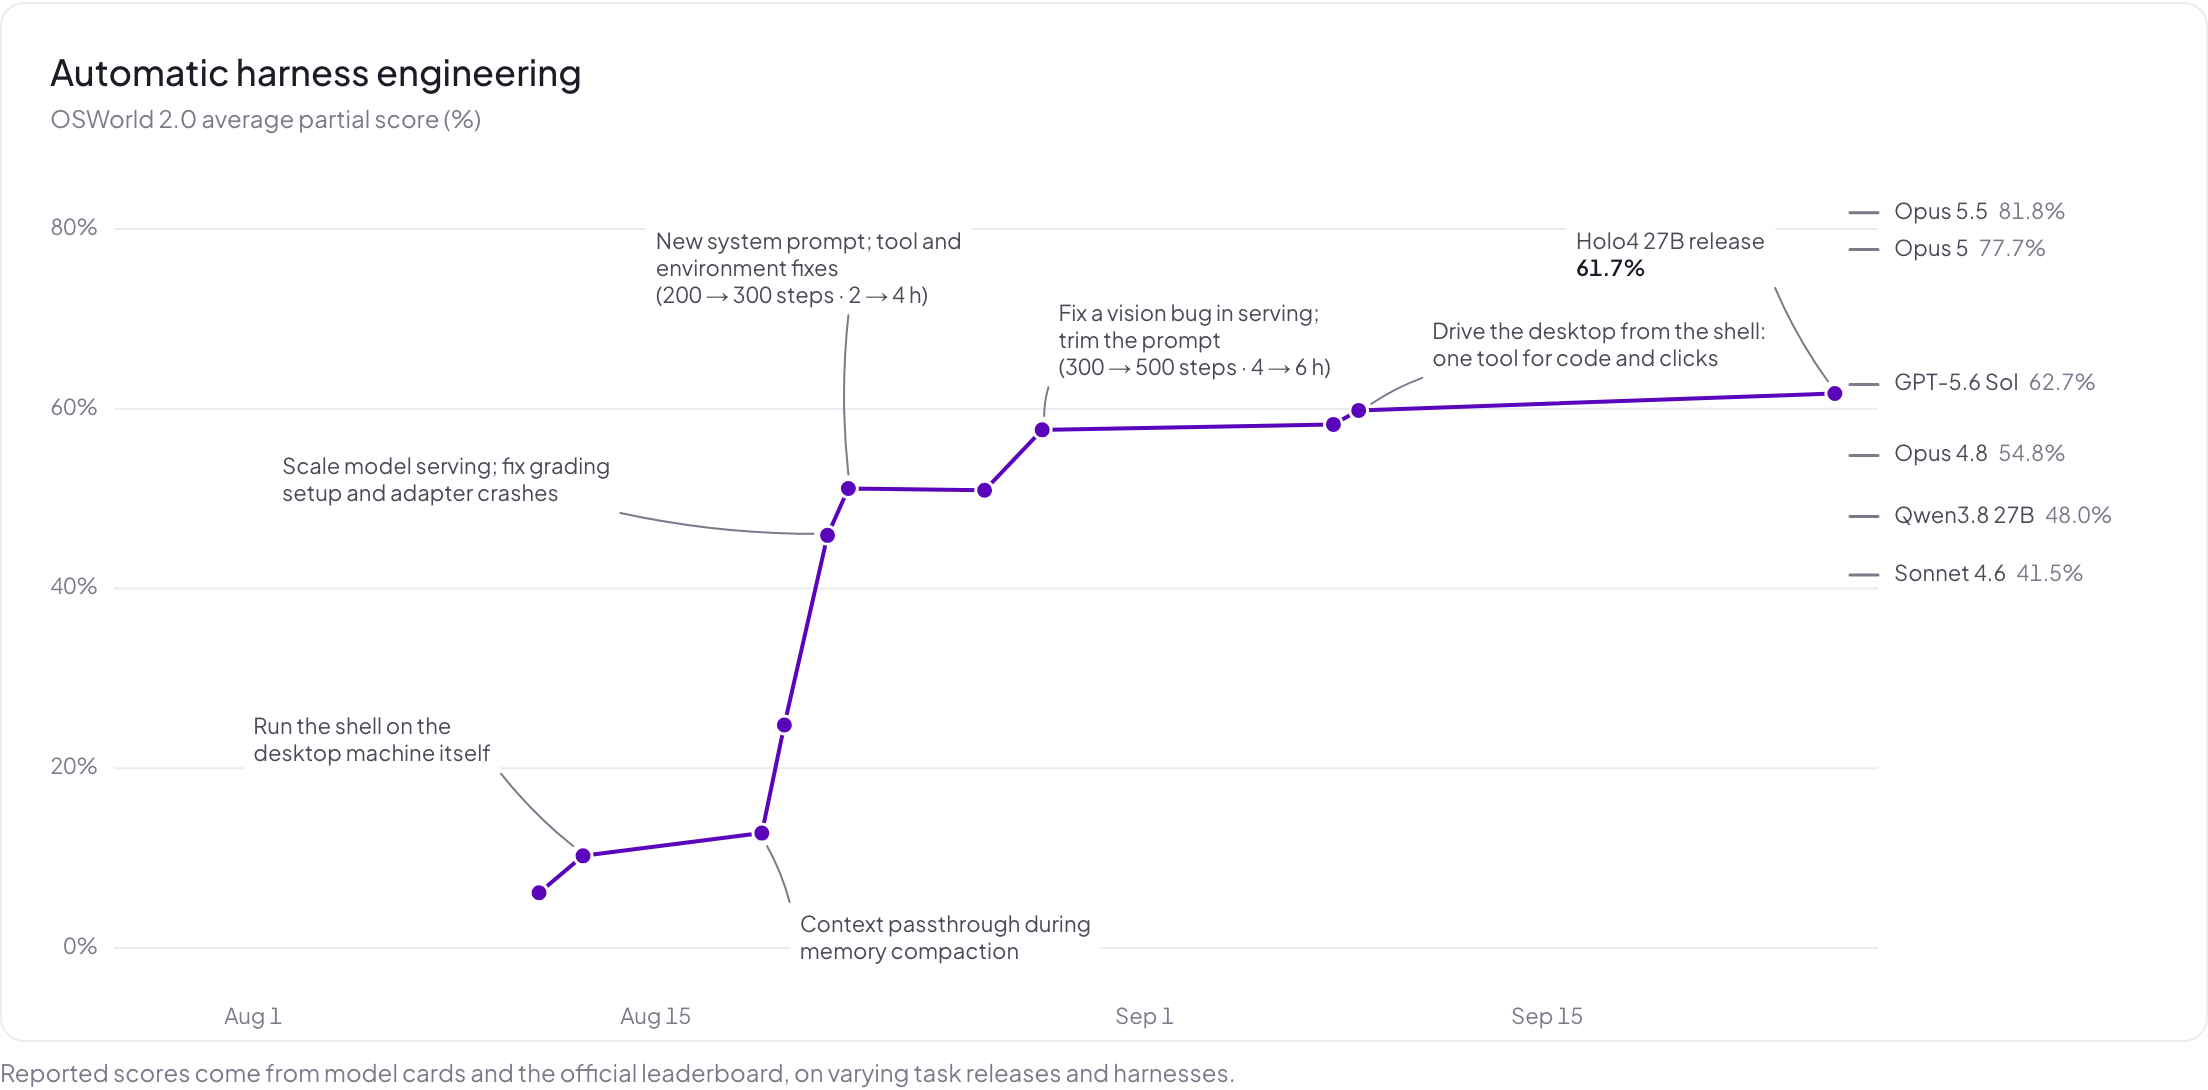
Opus 5(70.2%)和 GPT-5.6 Sol(66.2%)在 v2026.08.08 离线集上使用最大努力部分奖励,数据来自 OpenAI 的发布图表,与成本-性能图一致。其他参考分数来自模型卡和官方排行榜。任务版本、子集和测试框架各不相同。
Holotron4 Nano
我们的后训练栈旨在适配新的基础模型,并产出能跨界面和环境泛化的智能体。作为 NVIDIA Nemotron Coalition 的成员,我们将最新的栈应用于 Nemotron 3 Nano Omni 模型,作为 Holotron 3 的后续工作。
同样的配方将 Nemotron 3 Nano Omni 变为 Holotron4 Nano——一个通用智能体模型,在 GUI 工作流以及暴露 MCP、API 或编码沙箱的环境中相比基础模型有显著提升。
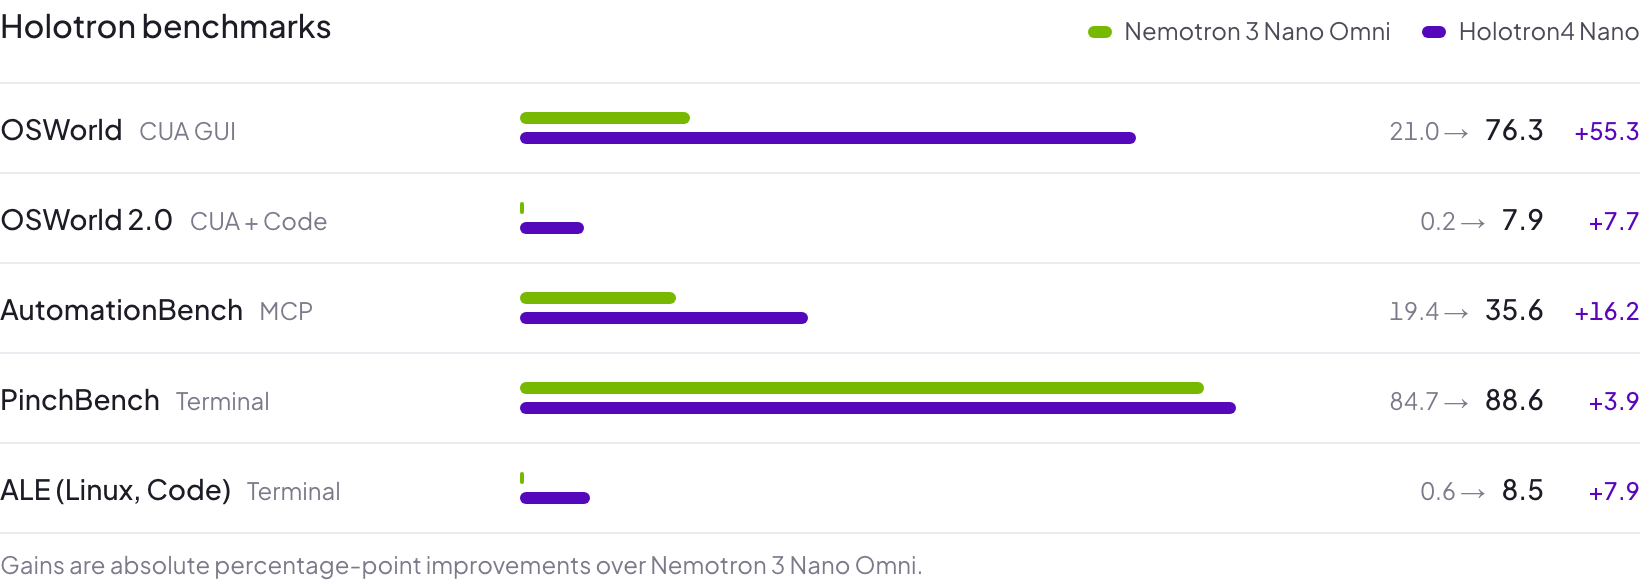
增益为相比 Nemotron 3 Nano Omni 的绝对百分点提升。
这些增益表明我们的配方迁移良好,可以将通用模型转变为智能体专家。其中没有任何部分是特定于规模的。
自行运行
两种规模现已在 H Models API 上提供。权重已在 Hugging Face 上以 BF16、FP8、NVFP4 和 4-bit GGUF 格式发布,与我们的一个小模型 Holotron4 Nano 并列。
我们将在未来几天发布优化后的 DSpark drafter 检查点,以进一步加速推理。
来源:Hugging Face Blog · hf-mirror.com